心情
心情之下,是读得到的状态:你是平静还是紧绷,专注度与负荷有多高。它不判断你开心还是难过。
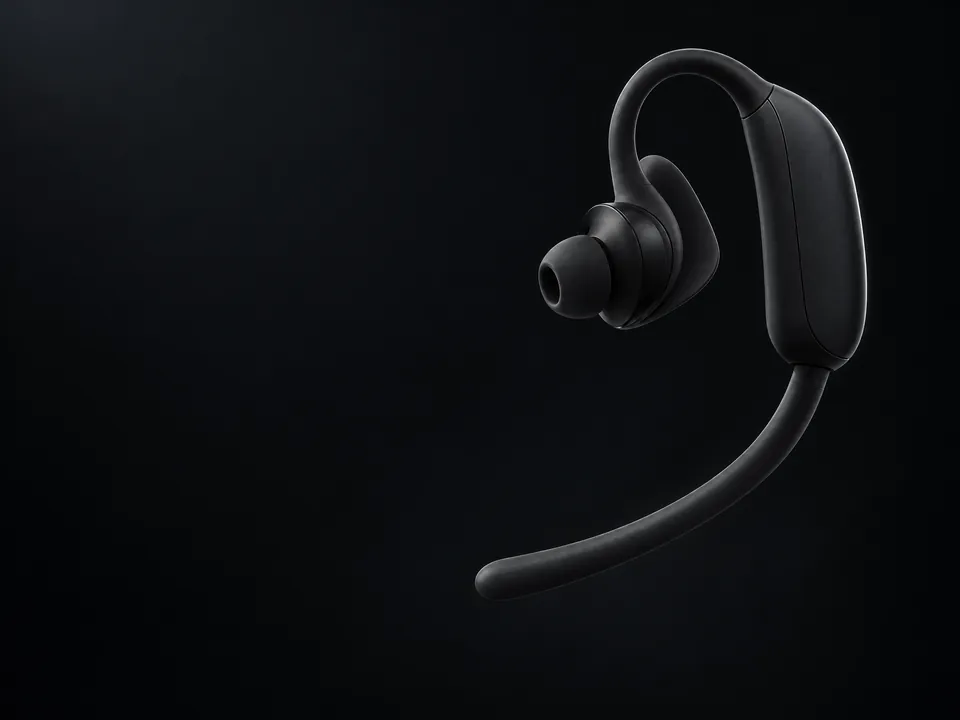
CYMBA C1-S 概念渲染
一对耳机,一根沿下颌的软悬臂,构成默读静默语音输入。
它读的是你默读时真正动起来的肌肉,不是你心里想的话。
状态指示 · 健康类,尚未验证
心情之下,是读得到的状态:你是平静还是紧绷,专注度与负荷有多高。它不判断你开心还是难过。
压力与恢复的趋势,以同一副电极拾取的心率与 HRV 为主,耳内脑电交叉核对。
夜间耳内脑电给出睡眠分期指示:清醒、REM、浅睡与深睡。
两只耳机里的耳内电极记录脑电,同一副电极也拾取心电。它们给出的是健康类状态指示,不是诊断,而且都还没有在我们的设备上验证。
耳内 α、θ 节律的变化,指示你有多专注、负荷有多重。
以心率变异性为主,用耳内 α 节律交叉核对,给出压力、恢复与唤醒水平的趋势。
夜间耳内脑电,指示清醒、REM、浅睡与深睡。
同一副电极拾取的心电,给出静息心率与 HRV 趋势。
默语 · 现在与未来
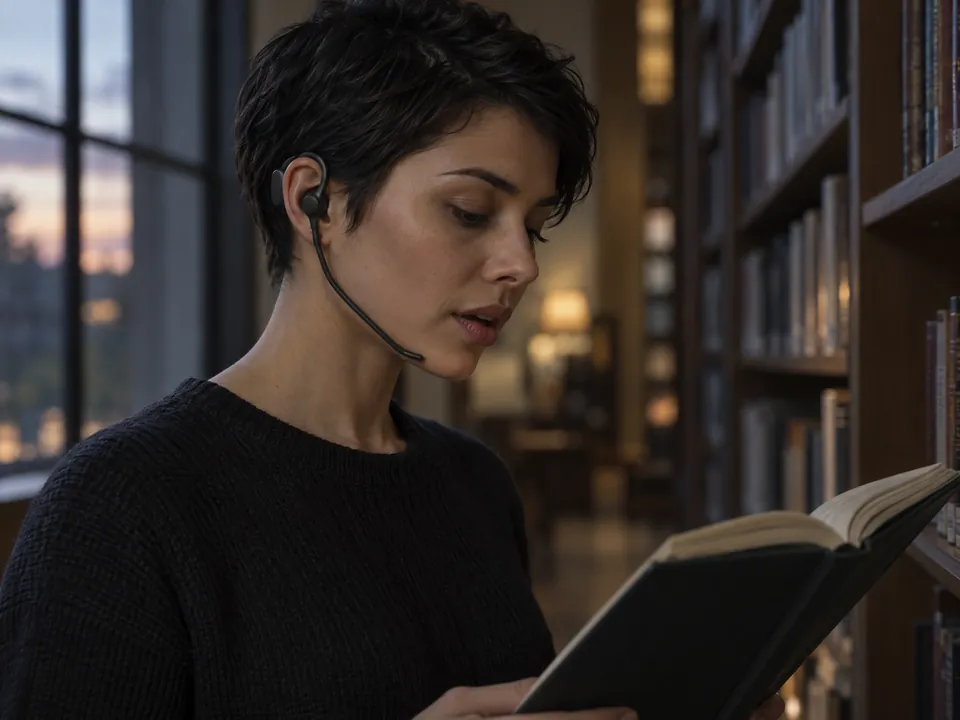
你做出一个词的发音动作,但不出声。悬臂读取下颌下方的肌电,匹配到一小组指令里。需要注册训练。
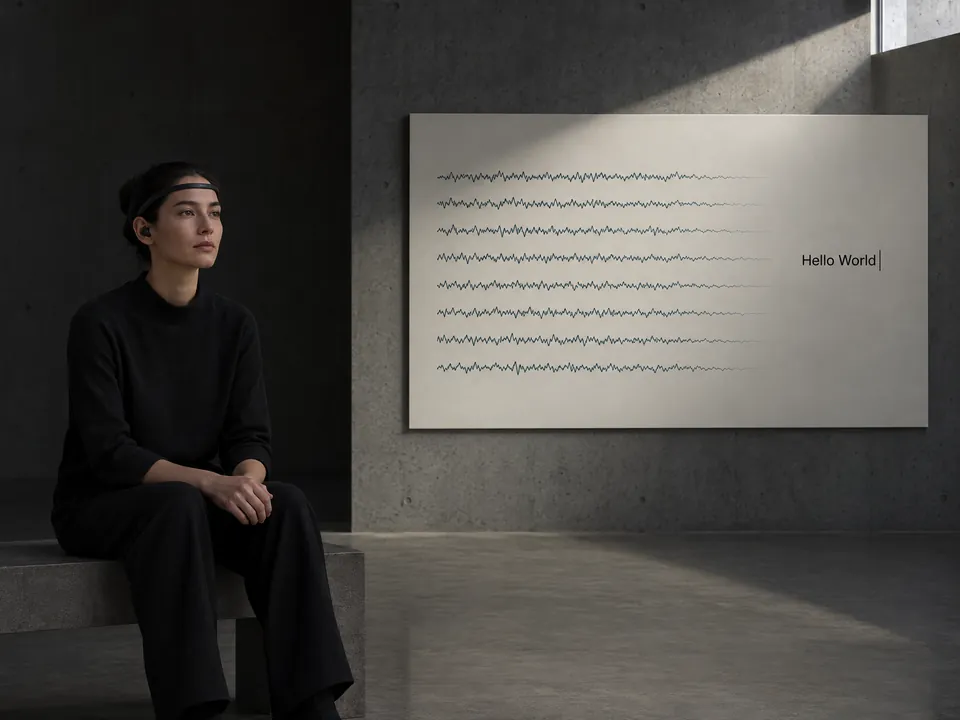
嘴唇不动,只在心里说。用非侵入式脑电做到这一点,目前公开研究的结果接近随机水平。我们在研究,不承诺时间,也不承诺准确率。
大模型 · 从信号到文字
解码器先把肌电或脑电变成一组候选词,每个词带着概率。大模型再按语言本来的规律权衡这些候选,写出最可能的那句话。
打开音乐
在已发表的静默语音研究里,加入大模型后,开放词表的词错误率从 28.8% 降到 12.2%。在 C1-S 上,大模型只在你的闭集指令与短语里工作。
脑电弱得多,大模型会承担大部分工作——而大模型很乐意把噪声补成一句通顺的话。所以每个脑电结果都要测两遍:一遍关掉大模型,一遍喂进纯噪声。如果噪声读出来和大脑一样好,那就什么也没读到。
置信度低于门限时,C1-S 什么也不显示,而不是给你一个猜测。
CYMBA C1-S 不读心。你不出声地默读一个词时,下颌下方的肌肉仍然在动。软悬臂上的电极拾取这段肌电,再由按你本人发音方式训练的解码器,把它匹配到一小组指令里。
指令、数字与短语。不是自由听写。
先学会你的发音方式才能用。不能开箱即用。
尚未在人身上验证。第一轮实验还没有做。
信号
电极
每只耳朵里,三枚干电极贴在耳甲,对耳屏上另有一枚参考电极。它们采集耳内脑电,用于专注度指示。
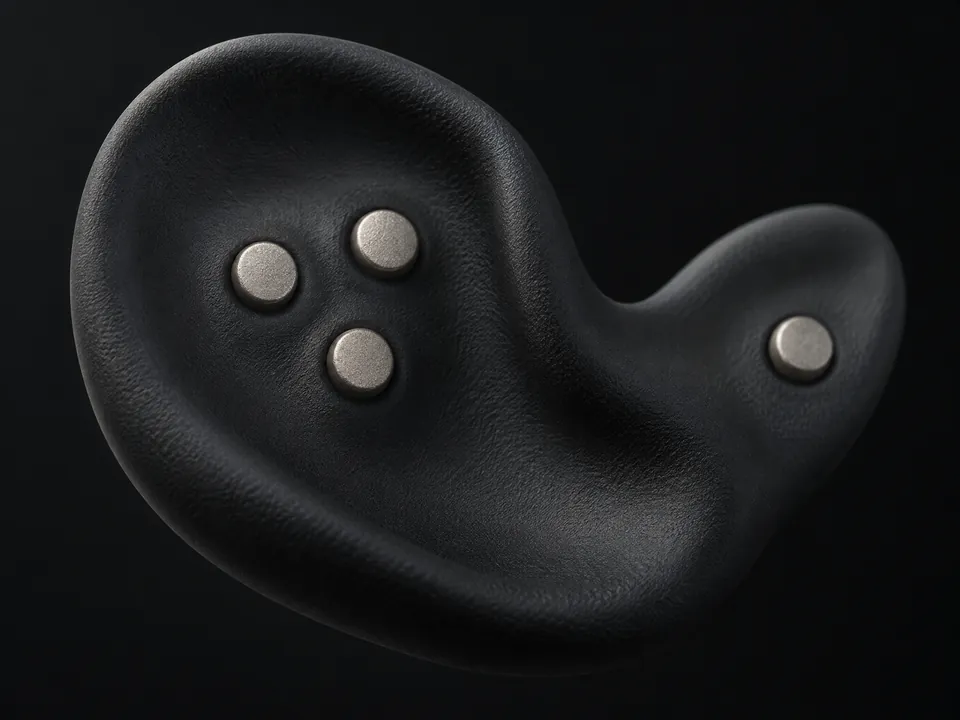
每只耳朵后面,三枚电极相距约 7 mm,呈浅锯齿排列,贴在皮肤上。
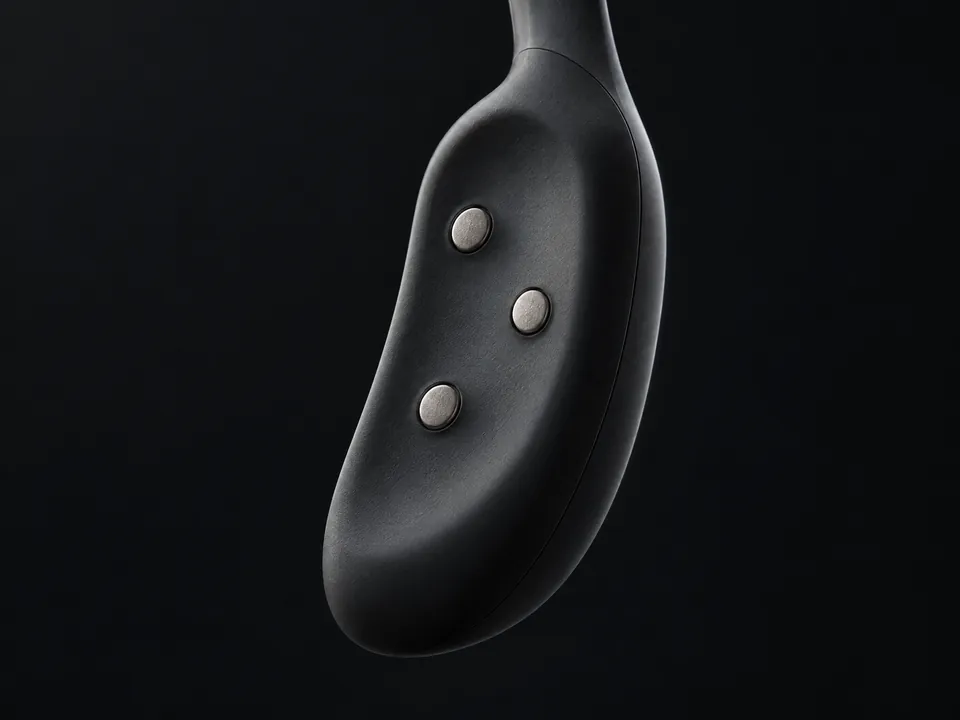
悬臂可以用手弯折,左右两只耳机都能装,顺着下颌走。靠近末端的四枚电极间距 12 mm,朝向下颌下方的皮肤。这个位置是否成立,正是第一轮实验要检验的。
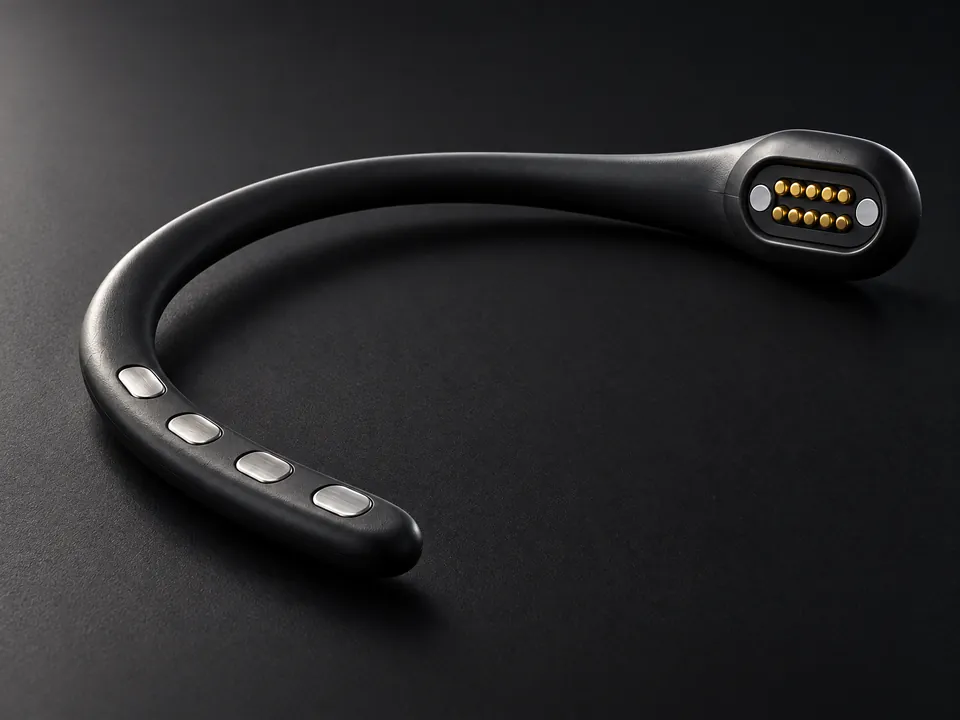
模式
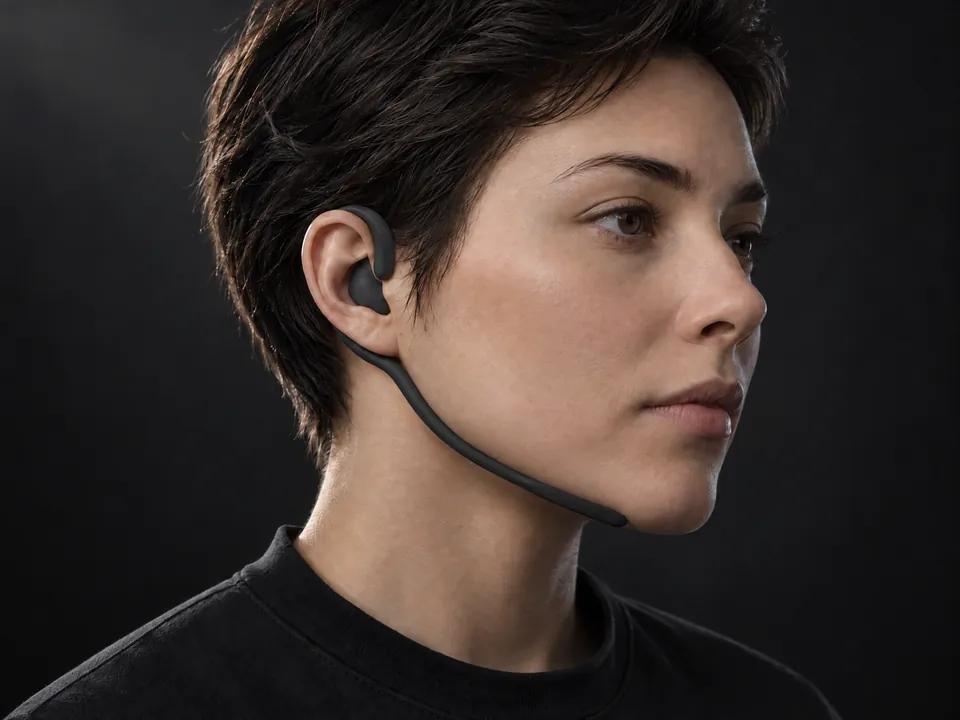
装上悬臂,不出声地默读指令。概念渲染
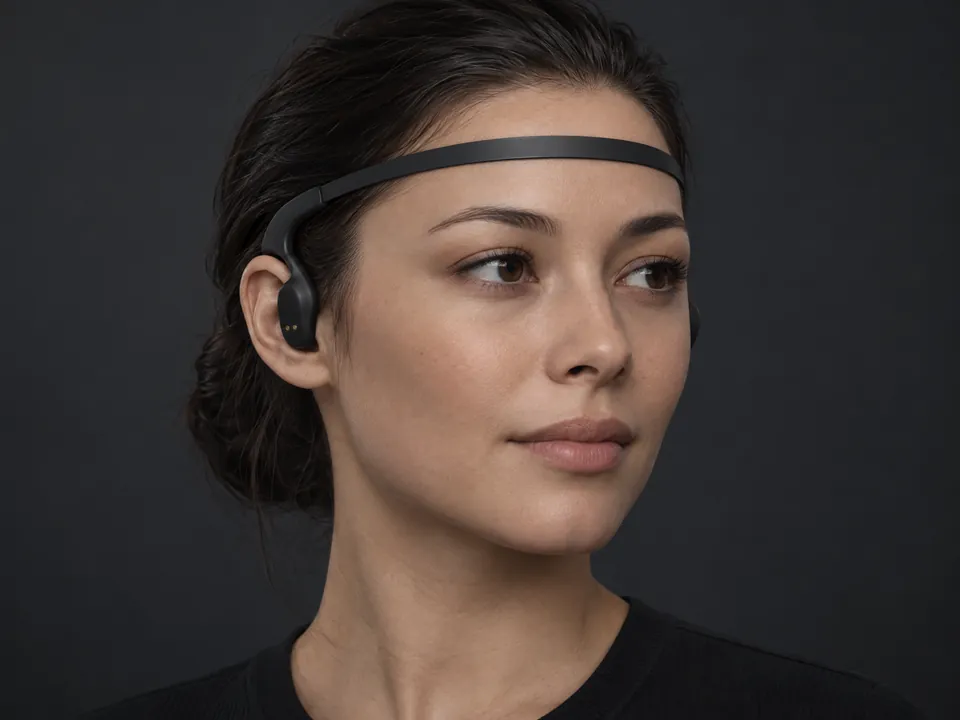
换上前额带,四枚电极贴在额头,用于专注度指示。这是健康类功能,不是医疗功能。概念渲染
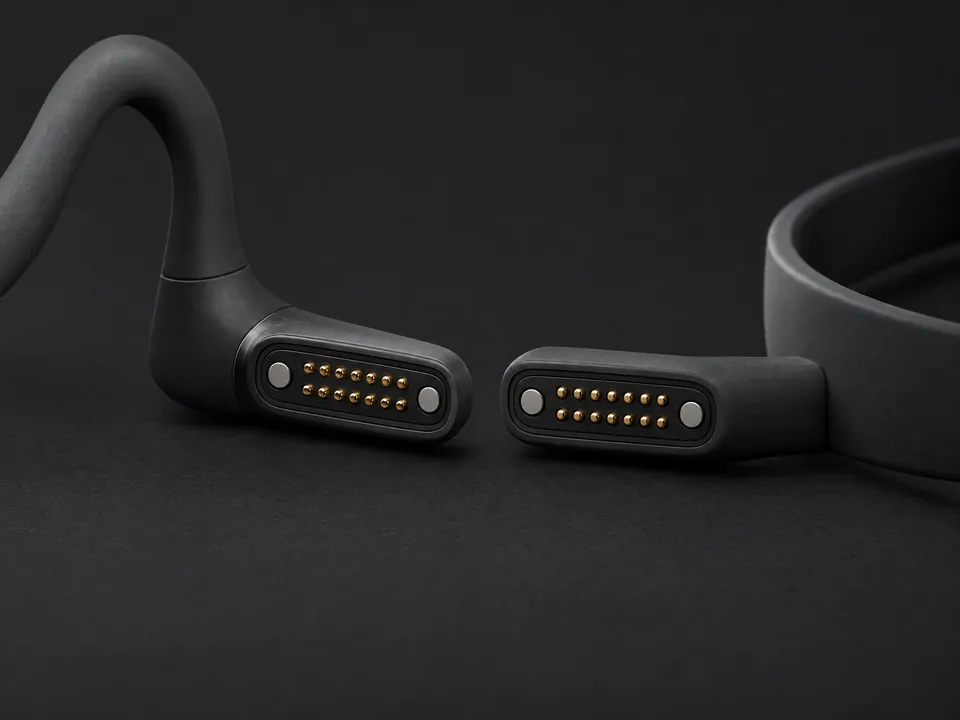
两只耳机上都有同样的磁吸座:悬臂装在任意一侧,前额带两端各接一只。两者从不同时佩戴。概念渲染
隐私 · 设计目标,尚未实现
双击咬肌,打开一个三秒窗口;再默读一句口令确认。除此之外一律保持锁定。
锁定时,蓝牙上完全没有信号数据。不是加密后的数据,而是没有数据。
解码期间耳机上的指示灯常亮,身边的人能看出来。解码窗口 60 秒后自动关闭,摘下耳机立即关闭。
概念规格 · 可能调整
全家
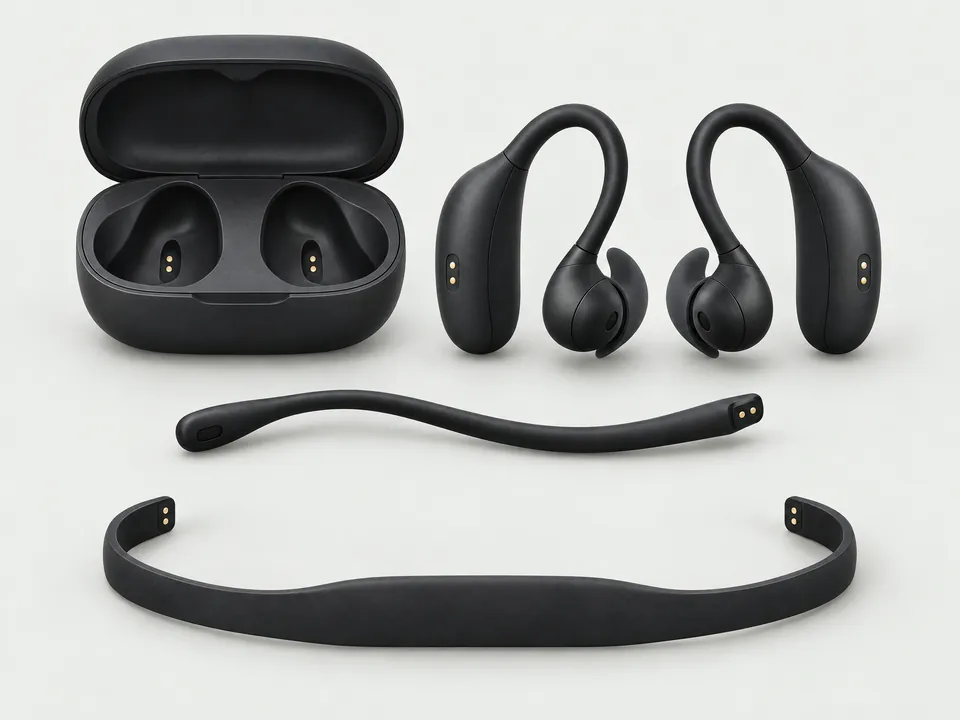
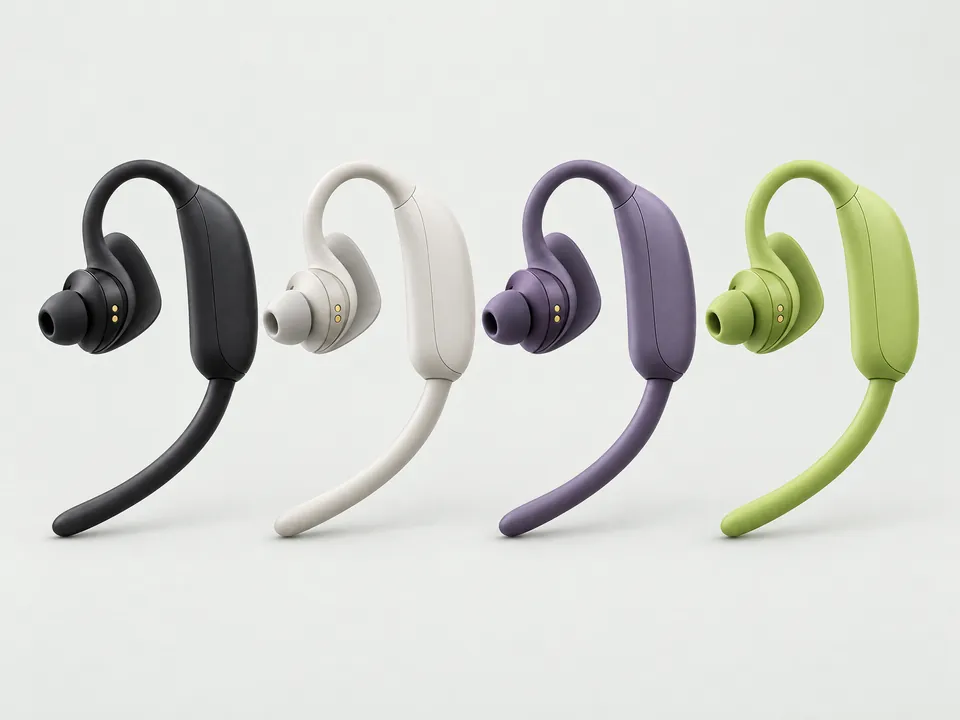
所有图片均为 AI 生成的概念渲染,不是实物照片;电极位置尚未在人身上验证。
CYMBA C1-S 是研发中的概念产品。它不解码内语,也不解码想法。静默语音输入需要注册训练,并且只有在你真正做出无声的发音动作时才能工作。状态指示属于健康类功能,不是诊断。不是医疗器械。